[ 2026 오픈소스 개발자대회 · 2차 평가 · 팀 하마 ]
omm
장비 한 대부터 조직 전체까지,
로컬 AI 인프라를 한 도구로 만듭니다
omm은 GPU 서버 없이도, 이미 가진 컴퓨터로 자신만의 로컬 AI 환경을 운영하게 해 주는 오픈소스 CLI 도구입니다
한 대
여러 대
조직
신민규
구민준
최아성
github.com/omm-hippo/omm
[ 01 · 필요성 ]
로컬 AI가 현실적인 선택이 된 이유
1
오픈 웨이트 모델이 최고 성능 모델을 몇 달 차이로 따라잡는다
2
작은 모델로 충분해졌고, 외부 AI API 비용은 기업 예산을 넘어선다
3
큰 회사 조직은 이미 민감한 데이터를 조직내에서 처리하는 쪽으로 이동
오픈 웨이트 모델: 학습된 가중치를 공개해 누구나 자기 장비에 받아 돌릴 수 있는 모델. 예: Qwen, Llama, EXAONE
[ 01 · 필요성 ]
오픈 웨이트 모델의 빠른 발전
4개월
몇 년이 아니라 몇 달 차이입니다
2025-10 분석 · 평균 3개월
2026-05 분석 · 2026년 들어 평균 4개월
2026-10 분석 · 보안(사이버) 영역 6–7개월
막대 길이 = 오픈 웨이트 모델이 폐쇄 모델에 비해 뒤처진 개월 수
[ 출처 ] Epoch AI, Open-weight models Data Insights (2025-10-30, 2026-05-29, 2026-10-16) · Epoch Capabilities Index 기준
[ 01 · 필요성 ]
AI 전용 대형 서버 불필요
Qwen3.5-9B
약 90억 파라미터 · 2026-03
노트북에서 도는 크기 (Q4 ≈ 5.7 GB)
≈
OpenAI gpt-oss-120b
약 1,170억 파라미터 · 2025-08
80 GB GPU가 필요한 크기
[ 출처 ] Hugging Face Qwen/Qwen3.5-9B 모델 카드 (2026-03) · GPQA Diamond 81.7 vs 80.1, MMLU-Pro 82.5 vs 80.8 · 제조사 자체 벤치마크, 코딩(LiveCodeBench)은 120b가 앞섬 · 넓이 = 파라미터 수 · 5.7 GB = omm 추천 후보 unsloth Q4_K_M 파일
[ 01 · 필요성 ]
기업의 AI API 비용은 예산을 넘는 중
기업 한 곳의 월 AI 토큰 지출
평균 $140,842
2026-04 · 중앙값 $2,246
데이터 -> 외부 서버
Uber, 2026년 AI 코딩 예산
4월에 소진
직원 1인당 도구별 월 $1,500 상한 도입
데이터 -> 외부 서버
내 장비의 로컬 AI 모델 (omm)
추가 과금 없음
- 장비와 전기료만
데이터 -> 사무실 안
최신 폐쇄 모델(OpenAI gpt-5.5)은 100만 토큰당 입력 $5 · 출력 $30. 최고 성능이 꼭 필요한 일은 여전히 폐쇄 모델이 앞서서(약 4개월), 큰 조직은 둘을 나눠 씁니다.
[ 출처 ] Ramp “How Much Do AI Tokens Cost Businesses?” (2026-06-08, 2026-04 결제 데이터) · TechCrunch “The token bill comes due” (2026-06-05) · Uber 상한: Bloomberg·TechCrunch (2026-06-02) · OpenAI API 가격표 (2026-10-28 조회)
[ 01 · 필요성 ]
대기업 10곳 중 8곳은 이미 로컬 AI 사용

78%
직접 운영
78% · AI 추론을 직접 운영
자체 서버, 전용 클라우드, 직접 띄운 오픈 웨이트 모델
19% · 외부 AI 서비스만
100 − 78 − 3으로 계산한 나머지
3% · AI 추론을 쓰지 않음
평균 2개
직접 운영하는 추론 서비스 수. 5곳 중 1곳은 3개 이상
남은 36%
주로 외부 AI 서비스에 기대는 기업은 셋 중 하나뿐
56→41%
운영 AI 추론에 공용 클라우드를 쓰거나 쓸 계획인 기업, 1년 사이 (Broadcom)
[ 출처 ] F5 “2026 State of Application Strategy Report” 3·10·29쪽 (세계 IT 결정권자 1,100명 이상, 4분의 3이 연 매출 10억–100억 달러 기업) · Broadcom “Private Cloud Outlook 2026” (2026-06, IT 리더 1,800명)
[ 01 · 필요성 ]
다음 흐름은 중소기업, 하지만 부족한 전문 인력
근로자 생성형 AI 활용률
대기업
66.5%
중소기업
52.7%
AI 도입 로드맵이 없다
대기업
54.4%
중소기업
70.4%
정부 목표
중소 제조기업 AI 도입률 2030년까지 1% → 10% · 5조 원 이상 투입
막는 것
초기 비용 부담 44.2%, 전문 인력 부족 20.5%
[ 출처 ] 대한상공회의소 SGI “생성형 AI 활용의 대-중소기업 격차” (2026-06-10, 근로자 약 3,000명) · 중소벤처기업부 “중소제조 피지컬 AI 확산 전략” (2026-10-29, 보도) · 중소기업중앙회 조사 (2025-10-19, 보도)
[ 01 · 필요성 ]
omm 하나로 로컬 AI 구축하기
필요한 것
대기업·공공이 하는 방식
■ omm으로 하는 방식
장비
GPU 서버 구매
→
사무실에 남는 Mac을 묶음
모델
자체 개발 또는 대형 계약
→
장비에 맞는 오픈 웨이트 모델을 추천·설치
사내 문서
별도 RAG 구축 사업
→
omm rag add · share
사람
전담 AI·인프라 팀
→
명령 몇 줄, 또는 웹 화면
[ 01 · 필요성 ]
국내 공공기관·금융권에서의 로컬 AI 수요가 증가 중
공공 · 2026-10
JDC, 외부망과 분리된 사내 AI 구축 사업
외부망과 분리된 내부 서버에 30B급·120B급 이상 언어모델 · 내부 문서 약 3.8 TB를 RAG로 검색 · 사업 기간 6개월
금융 · 2024-08 ~
망분리 규제 안에서 생성형 AI를 단계적으로 허용
외부 AI 연결은 강화된 보안 조건과 금감원·금융보안원 점검을 거쳐서만. 내부 처리가 가장 쉬운 길
omm이 하는 일과 같은 구조:
사내 서버의 언어모델 + 사내 문서 검색
[ 출처 ] 파이낸스스코프 (2026-10-21) “이스트소프트, JDC ‘사내 생성형 AI 언어모델 구축 사업’ 수주” · 금융위원회 보도자료 “금융분야 망분리 개선 로드맵” (2024-08-13)
[ 02 · 목표 ]
omm의 목표는 로컬 AI 인프라의
표준 도구가 되는 것입니다
한 대
→
여러 대
→
조직
GPU 서버와 전문 엔지니어 없이, 이미 가진 장비로.
컴퓨터 한 대에서 시작해 여러 대, 조직 전체까지 같은 명령으로 넓혀 갈 수 있습니다.
apt와 Homebrew가 패키지 관리의 표준이 된 것처럼, 이미 가진 장비를 이어 로컬 AI 환경을 만드는 표준
omm
로컬 LLM 모델 매니저
팀 하마
로컬 LLM의 3가지 걸림돌
실행 여부 불명
중복 다운로드
복잡한 설치
1내 PC에 맞는
모델 선택
모델 선택
1 모델 선택2 모델 관리3 사내 AI4 웹 화면
다운로드 완료 후에야
확인되는 메모리 부족
확인되는 메모리 부족
omm search · fit
모델 검색과 실행 가능 여부 사전 판정
원래는
사이트별 개별 검색
5 GB 다운로드
실행 시 메모리 부족
omm으로
통합 검색
여유 메모리 대조
다운로드 전 판정
여유 메모리 계산과 3단계 판정
여유 메모리현재 빈 메모리 − 안전 여유 10%
필요 메모리모델 파일 크기 × 1.2
판정즉시 실행 · 앱 종료 후 실행 · 실행 불가
수십 개 후보 중
최적 모델 판단 불가
최적 모델 판단 불가
omm recommend
PC별 예상 속도 기반 추천
원래는
파일 크기 기준 선택
직접 다운로드·실행
속도 미달 시 재다운로드
omm으로
PC 사양 자동 수집
모델별 속도 예측
최적 모델 추천
omm recommend
M5 맥북 모델별 예측과 실측 속도
크기예측실측
EXAONE 4.0 1.2B0.8 GB94[ ]
EXAONE 3.5 2.4B1.6 GB48[ ]
glm edge 4B2.6 GB26[ ]
LocalFit: 이 PC 기준 모델별 속도 예측
입력M5 + 2.4B 모델
LocalFit트리 64개 평균
예상 속도초당 약 48토큰
4단계 추천 기준
1 메모리여유 메모리 이내
2 속도초당 5토큰 이상
3 크기큰 모델 우선
4 다양성계열당 2개, 최대 10개
경량·안전 모델 배포
JSON 트리실행 코드 없는 형식
추가 설치 불필요학습 라이브러리 미포함
서명 검증위조 모델 차단
매일 재학습,
성능 저하 시
배포 거부
성능 저하 시
배포 거부
신규 모델 배포 조건
평가 데이터학습 제외 실측 20%
오차2% 초과 증가 시 거부
1위 적중률하락 시 거부
omm contribute
자동 측정 기반 추천 데이터 기여
자동 실행
적합 모델 다운로드
속도 측정
결과 업로드
누구나 참여
명령어 한 줄
오픈소스 기여
추천 정확도 향상
2한 번 설치,
모든 앱에서 사용
모든 앱에서 사용
1 모델 선택2 모델 관리3 사내 AI4 웹 화면
동일 파일 3중 저장,
디스크 낭비
디스크 낭비
omm install
1회 다운로드, 링크로 공유
원래는
앱 3개 사용
앱별 5 GB 저장
중복 저장 15 GB
omm으로
허브에 1회 저장
앱에는 링크
총 5 GB
omm import · link
기존 모델 통합과 전체 앱 연결
원래는
앱별 분산 저장
동일 파일 중복
용량 낭비
omm으로
허브로 통합
7개 앱 연결
단일 파일 공유
import: 해시 기반 중복 파일 탐지
폴더 검사SHA-256 해시
허브 보관나머지는 링크
실패 시원상 복구
링크 실패 시 자동 대체,
끊긴 링크 자동 복구
끊긴 링크 자동 복구
하드링크Windows
심볼릭 링크macOS·Linux
복사최후 수단
Ollama: 복사 없는 모델 등록
허브 파일원본 1개
blob링크 연결
manifestomm 직접 작성
비공개 형식 대응 안전장치 3종
호환 확인거부 시 공식 방식 전환
소유 기록omm 생성 파일만 삭제
공유 blob미사용 시에만 삭제
앱별 연결 방식
Ollamablob 링크 + manifest
LM Studio폴더 구조 맞춤 링크
Jan설정 파일에 경로 기록
KoboldCpp승인 후 복사
개인 PC 시연
3함께 쓰는
사내 AI
사내 AI
1 모델 선택2 모델 관리3 사내 AI4 웹 화면
GPU 서버 대신
보유 컴퓨터 여러 대
보유 컴퓨터 여러 대
omm cluster
여러 대를 하나의 AI 서버로
원래는
큰 모델
1대에 적재
메모리 부족
omm으로
큰 모델
3대에 분산
단일 서버처럼 실행
클러스터 3가지 역할
관리자클러스터 구성·관리
연산 컴퓨터분산 계산
직원기존 도구로 사용
명령어 한 줄, 설정 자동화
cluster init게이트웨이·인증서·방화벽 구성
cluster join네트워크·절전 해제·exo 실행
cluster leave변경 설정 원상 복구
단일 입구, 직원 인증 후 접근
직원 PC요청
게이트웨이토큰 검증
클러스터답변 생성
k8s 방식: 목표 상태 자동 유지
30초마다모델 점검 → 누락 시 재적재
60초마다버전 점검 → 서명 버전 동기화
합류 시절전·방화벽 설정 → 탈퇴 시 원상 복구
개발 중 발견한 문제 3가지와 해결
네트워크 마비포트별 개별 연결
모델 소실30초 주기 재적재
관리자 교체명령어 한 줄 이전
문제 ① 네트워크 마비: 원인과 해결
순환 구조3대 고리형 연결
패킷 폭주패킷 무한 순환
포트별 연결탈퇴 시 복구
문제 ② 모델 소실: 원인과 해결
메모리 저장exo 배치 정보
재시작 시 소실응답 중단
30초 점검자동 재적재
문제 ③ 관리자 교체: 원인과 해결
헤드 집중입구·문서 저장
헤드 교체 시처음부터 재구성
handover한 줄로 이전
사내 문서는
외부 AI 금지
외부 AI 금지
omm rag
외부 유출 없는 사내 문서 검색
원래는
사내 문서
외부 AI 업로드
보안 위반
omm으로
사내 색인
관련 내용 검색
로컬 AI 답변
omm rag share
문서별 열람 권한 지정
원래는
모든 문서
모든 직원 열람
인사 자료 노출
omm으로
문서 묶음별
열람자 지정
허가된 직원만 검색
omm agent
기존 코딩 도구의 사내 AI 연결
원래는
AI 코딩 도구
API 설정 수정
복잡한 수동 설정
omm으로 · 원상 복구도 한 줄
AI 코딩 도구
사내 클러스터
코드 외부 유출 차단
사내 AI 시연
4모든 기능을
브라우저에서
브라우저에서
1 모델 선택2 모델 관리3 사내 AI4 웹 화면
omm web
누구나 쉬운 브라우저 관리
원래는
터미널 명령어
세부 옵션 지정
비개발자 진입 장벽
omm으로
브라우저 화면
직관적인 버튼
클릭만으로 사용
추천·설치·대화를 클릭으로
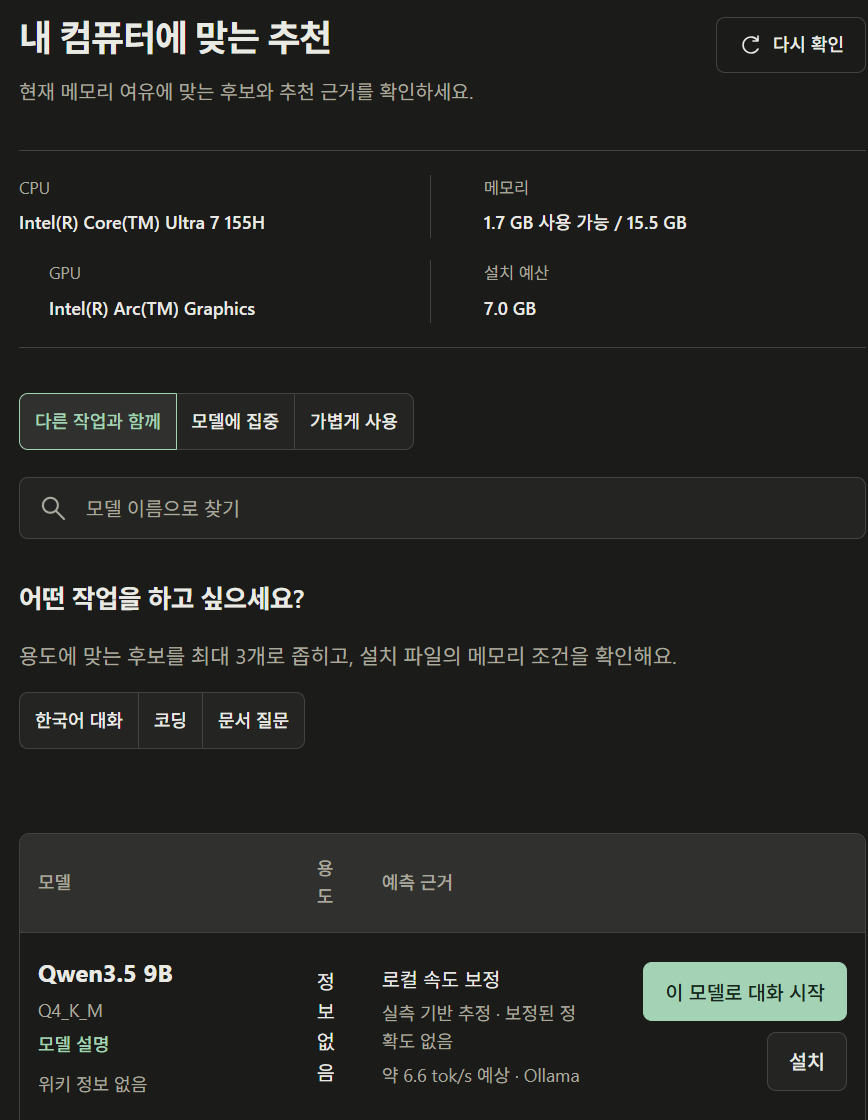
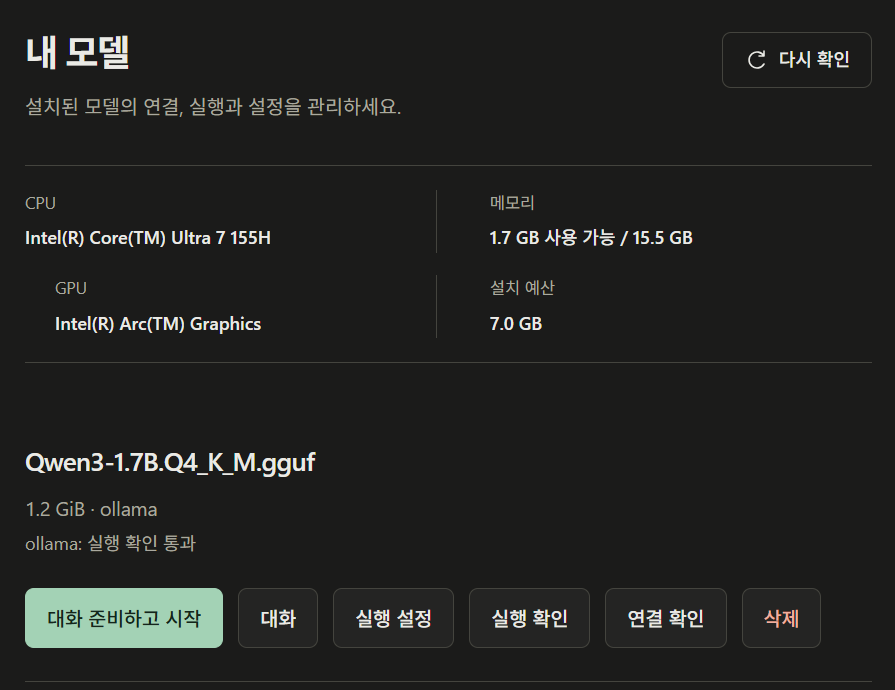
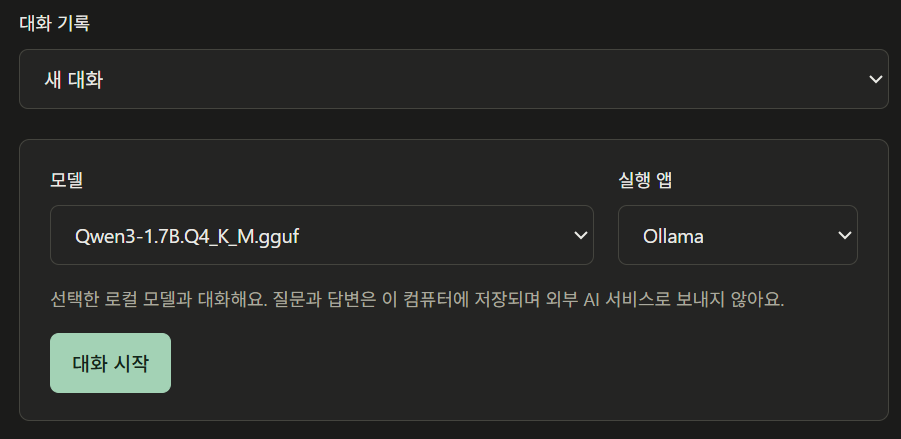
문서 질문·상태 확인도 웹 화면에서
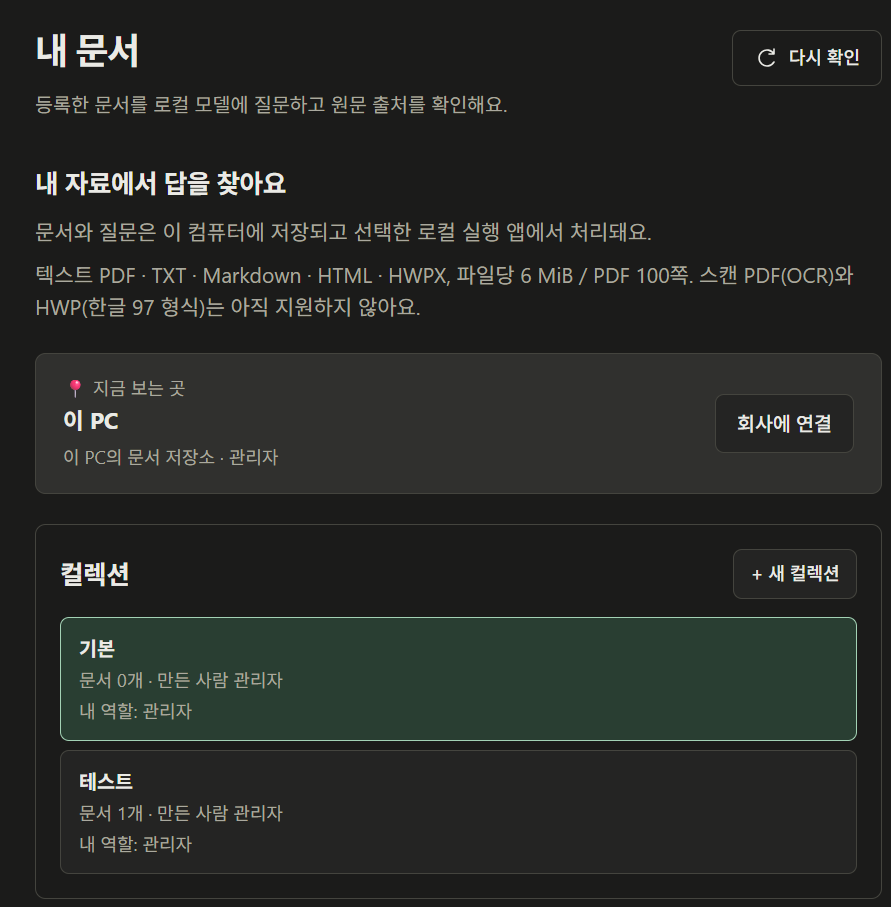
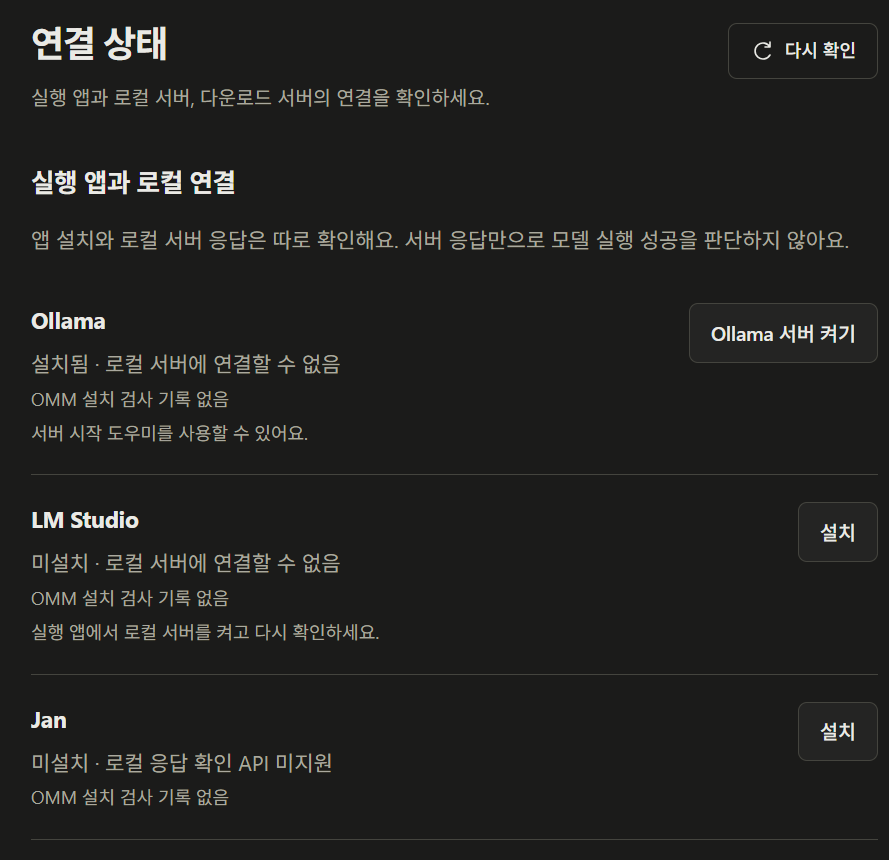
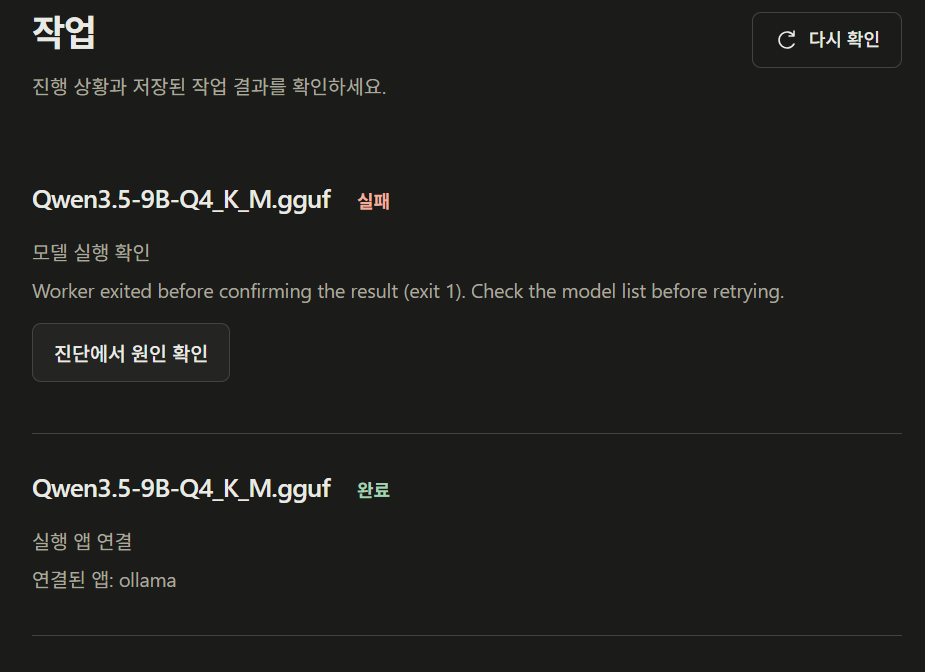
기존 도구 위에 연결 계층 개발
기존 도구 역할→omm 담당 영역
Ollama 등→모델 공유·검증
Hugging Face→속도 예측 추천
exo→클러스터 운영
사용자 PC들→공개 속도 데이터
신뢰할 수 있는 배포 체계
서명검증된 파일만 설치
보호 브랜치CI 테스트 + 팀원 리뷰
프롬프트외부 전송 없음
라이선스MIT, 의존성 자동 검사
개발 진행 현황
개인 PC3개 OS 공개 배포
사내 AI문서 검색·에이전트 연결 검증 중
다음 단계클러스터 전 플랫폼 지원
설치 경로: curl · Homebrew · pipx · npm · Windows ZIP
선택·설치·연결·운영까지 한 번에
omm.run · github.com/omm-hippo/omm
[ 부록 ]
A1 지원 환경
A5 추천 모델
A9 개발 방식
A2 명령 체계
A6 벤치마크 수치
A10 데이터와 프라이버시
A3 라이선스·SBOM
A7 클러스터 상세
A11 1차 이후 달라진 것
A4 보안 모델
A8 문서 검색 상세
A12–13 예상 질문과 답
A14–16: ‘필요성’ 구간의 웹 출처 링크
맨 뒤: 발표에서 뺀 장 9개 (중복 저장, 추천 원리, 설치 검사, 클러스터 운영, 멘토링 반영, 막히는 4가지 유형, 사용자 문제, 회사 문제, 추론 비용 감소)
[ 부록 A1 ]
지원 환경
항목
내용
운영체제
macOS · Linux · Windows 10 22H2 이상 / 11
실행 앱 (7)
Ollama · LM Studio · Jan · AnythingLLM · Msty · text-generation-webui · KoboldCpp
설치 방법
설치 스크립트(curl / PowerShell) · Homebrew · pipx(PyPI omm-model) · npm(@omm-hippo/omm) · Windows 포터블 ZIP
런타임
Python 3.10 이상
실제 생성 확인
Ollama · LM Studio의 로컬 API
여러 대(클러스터)
macOS 26.2 이상 · Thunderbolt 연결 Mac · 다음 단계: Windows·Linux
직원 PC
운영체제 무관 (CLI 또는 웹 화면)
[ 부록 A2 ]
명령 체계: apt·brew처럼 직관적인 명령어
묶음
대표 명령 (모두 omm 뒤에)
시작
setup · scan · doctor · log
찾기
search · recommend · info
설치·관리
install · uninstall · upgrade · list · link · import · cleanup
확인·실행
verify · benchmark · run · arena
문서
rag add · search · share · team · connect · remote set
여러 대
cluster init · join · status · install · load · token · handover · leave
설정
setting upload · agent · auto-import
화면
web
[ 부록 A3 ]
라이선스와 SBOM (주요 실행 의존성)
라이브러리
라이선스
용도
typer · click
MIT · BSD-3-Clause
CLI 명령 체계
rich
MIT
터미널 표·진행 표시
psutil
BSD-3-Clause
하드웨어 측정
requests
Apache-2.0
다운로드·원격 통신
cryptography
Apache-2.0 OR BSD-3
Ed25519 서명 검증
questionary · prompt_toolkit
MIT · BSD-3-Clause
대화형 선택
filelock
MIT
동시 접근 잠금
certifi
MPL-2.0 (파일 단위)
TLS 인증서 묶음 · omm 라이선스에 영향 없음
scikit-learn
BSD-3-Clause
추천 모델 학습 (CI 전용, 배포본에 없음)
[ 부록 A4 ]
보안 모델
대상
방법
추천 모델 파일
pickle 대신 JSON(실행 코드 불가) · Ed25519 서명 · 검증 실패 시 이전 캐시 사용 · 이전 스냅샷 롤백
omm 업데이트
새 커밋의 SSH 서명을 허용된 서명자 목록과 대조, 실패하면 업데이트 거부
모델 다운로드
HTTPS · 크기 · SHA-256 대조 (해시 일치는 무결성일 뿐 안전성 보증이 아님을 표시)
클러스터 입구
헤드 게이트웨이 하나만 LAN에 노출 · HTTPS 전용 · 평문 요청은 거절
인증서
헤드가 자체 CA를 만들고, 직원 PC는 지문을 확인한 뒤 그 파일만 신뢰
직원 토큰
해시로만 저장, 한 번만 표시, 즉시 회수 가능, 검증 실패 시 거부
Mac 사이
pf 방화벽 규칙으로 Thunderbolt·로컬 외 접근 차단 · Mac끼리 요청은 클러스터 키로 서명
[ 부록 A5 ]
추천 모델
항목
내용
입력 특징
RAM · VRAM · 통합 메모리 여부 · CPU/GPU 칩 점수 · 코어 수 · 모델 크기·양자화 · 실행 앱
모델
RandomForestRegressor 64 트리 → 예상 tokens/sec · JSON 약 3.35 MiB
데이터
실측 원시 488행 → 유효 331행 → 고유 구성 233개 + 합성 기준 데이터 = 학습 25,433행
재학습
GitHub Actions가 매일 시도. 무효 비율 25% 이하 · 고유 실측 구성 100개 이상일 때만 품질 검사 진행
품질 검사
검증한 후보 그 자체를 배포. 특정 환경 오차가 크면 배포하지 않고 기존 모델 유지
개인정보
사용자명·호스트명·IP·파일 경로·생성 문장은 전송하지 않음
한계
측정 데이터가 일부 기종에 편중 · Ollama 중심 측정
[ 부록 A6 ]
벤치마크 수치
장비
모델
tok/s
첫 토큰
측정일
[시연 노트북]
[모델]
[ ]
[ ]
[ ]
[시연 노트북]
[예측값 대비]
[ ]
[ ]
[ ]
[Mac 1대]
[클러스터 모델]
[ ]
[ ]
[ ]
[Mac 3대 클러스터]
[클러스터 모델]
[ ]
[ ]
[ ]
측정: omm benchmark (한 대) · omm cluster benchmark (여러 대). 한 대와 세 대를 같은 모델로 비교하면 2차 멘토링이 권한 “단일 PC 대비 비교”가 됩니다.
[ 부록 A7 ]
클러스터 상세: 실제 장비에서 막힌 것과 푼 방법
막힌 것
omm이 한 일
Thunderbolt 브리지 패킷 폭주
Mac 셋을 고리로 이으면 5초에 38,000개 이상. 브리지 대신 포트마다 DHCP 연결, 나갈 때 원래대로
앱 안에서 실행한 exo 멈춤
exo 실행 파일을 복사해 omm 백그라운드 서비스로 실행
열린 포트
pf 방화벽: Thunderbolt·로컬만 허용, exo API와 높은 포트는 외부 차단(응답은 즉시 거절)
잠든 Mac 이탈
합류할 때 절전 끄기, 원래 값 저장 후 나갈 때 복원
재시작하면 사라지는 모델
30초마다 확인해 다시 올림 (모든 Mac을 최대 10분 기다림)
헤드 교체
cluster handover: 문서 저장소 스냅샷을 넘기고 새 헤드가 게이트웨이를 엶
버전 어긋남
멤버는 60초마다 헤드에 보고하고, 헤드와 같은 서명 커밋으로 업데이트
[ 부록 A8 ]
문서 검색(RAG) 상세
항목
내용
형식
텍스트 PDF · TXT · Markdown · HTML · HWPX
검색
의미 검색 + 단어 검색(하이브리드). 의미 검색이 안 되면 단어 검색으로 내려가고 이유를 알림
임베딩
로컬 Ollama 임베딩 모델 (바꾸면 reindex)
단위
컬렉션(문서 묶음) · 직원 또는 팀에 공유·회수 · 원본 파일은 지우지 않음
한 대에서
내 PC 문서를 코딩 도구에 MCP 서버로 연결
조직에서
헤드 Mac에 저장, 직원 PC는 rag remote set으로 헤드를 가리킴. 멤버 Mac이 백업 보관
연결 도구
Claude Code · Codex · pi · Cursor (설정 백업 후 등록, 연결 해제 시 omm 항목만 제거)
[ 부록 A9 ]
개발 방식: 세 명이 AI 에이전트와 함께 만드는 규칙
규칙
내용
main 보호
직접 push 금지 · PR + 필수 검사 6개 통과 · 관리자도 예외 없음
서명 체인
머지 커밋만 허용(스쿼시 금지) · SSH 서명이 끊기면 업데이트 클라이언트가 거부
PR 설명
한국어 네 항목(한줄 요약·배경·무엇을 바꿨나·어떻게 확인했나)을 CI가 검사
문서 동기화
명령을 바꾸면 commands.json과 README를 CI가 대조
자동화
워크플로 20개: 운영체제별 검증, 실행 앱별 검사, 매일 재학습, 자동 릴리스
AI 활용
Claude Code · Codex로 작성, 사람이 리뷰·검증 후 머지 (1차 결과보고서에 비율 공개)
[ 부록 A10 ]
데이터와 프라이버시: 네 채널 모두 사용자가 켤 때만
채널
보내는 것
절대 안 보내는 것
벤치마크
하드웨어 특징, 모델·실행 앱, 측정 속도
사용자명·호스트명·IP·경로·생성 문장
사용 통계
임의 ID, 버전, OS, 메모리 구간, 명령별 성공·실패 횟수
모델 이름·경로·인자·IP
오류 보고
오류 정보 (비공개 저장)
입력한 내용
대결 투표
이긴 쪽, 두 모델 정보, 속도·메모리
입력한 질문 (서버가 이름으로 거부)
실행 기록(로그)은 이 컴퓨터에만 남고 어느 채널도 읽지 않습니다. 설정: omm setting upload
[ 부록 A11 ]
1차 평가 이후 달라진 것
영역
1차 (2026-08-27 결과보고서)
2차 (2026-10-28)
정체성
로컬 LLM 모델 패키지 매니저
로컬 AI 인프라 도구 (한 대 → 여러 대 → 조직)
화면
CLI
CLI + 웹 화면 (메뉴 11개)
문서
없음
문서 검색(RAG), 팀 공유, MCP
여러 대
없음
Mac 클러스터, 게이트웨이, 헤드 교체
도구 연결
실행 앱 7종
+ Claude Code · Codex · pi · Cursor
안정성
설치·링크 검사
+ 설치 중단 복구, 오류별 다음 행동, 설정 저장·복원
버전
[1차 당시 버전]
0.4.84
[ 부록 A12 ]
예상 질문과 답의 요지
질문
답의 요지
답
Ollama가 있는데 왜 또?
Ollama는 실행기, omm은 그 위의 관리자. 고르기·받기·연결·확인을 한 곳에서
신민규
exo를 쓰는데 omm은 뭘 했나
네트워크·방화벽·게이트웨이·토큰·재적재·헤드 교체·문서 검색 (A7)
신민규
데이터가 정말 안 나가나
추론·임베딩·문서 저장 모두 사내. 밖으로는 동의한 통계뿐, 질문은 절대 안 보냄 (A10)
최아성
Windows에서도 되나
한 대는 3개 OS. 클러스터는 지금 Mac만, 다음 단계가 llama.cpp 기반 멀티 플랫폼
신민규
추천은 얼마나 맞나
실측으로 매일 재학습, 검사 못 넘으면 배포 안 함. 데이터 편중은 한계 (A5)
최아성
사용자는 얼마나 되나
초기 단계. [발표 전날 PyPI·npm 수치 갱신]
신민규
라이선스 문제는
MIT, 의존성 48개 확인, 카피레프트 없음 (A3)
최아성
[ 부록 A13 ]
예상 질문과 답의 요지 (2)
질문
답의 요지
답
이름은 Model Manager인데 인프라 도구인가
1차에는 모델 관리자였고, 같은 이름과 같은 명령 체계로 범위를 넓혔습니다
신민규
코드 대부분을 AI가 썼다는데
설계·리뷰·검증은 사람. 머지 전 필수 검사 6개와 테스트 4,359개. AI 코드를 검토하는 능력이 이 프로젝트에서 배운 것 (2차 멘토링 9장)
신민규
추천 모델은 최근에 갱신됐나
아니요. 8/20 모델을 유지 중. 새 후보가 처음 보는 기종에서 덜 맞아 품질 검사에서 거부됨. 검사가 일하는 증거
최아성
클러스터도 같은 모델 파일을 쓰나
지금은 exo용 MLX 형식이라 따로 받습니다. llama.cpp 기반으로 바꾸면 한 대의 GGUF를 그대로 씁니다
신민규
삼성도 외부 AI를 쓰는데 로컬이 필요한가
삼성도 사내 데이터는 자체 AI가 맡는 투트랙. omm은 그 안쪽 AI를 중소기업도 갖게 하는 도구
신민규
[ 부록 A14 ]
웹 출처 (1) 오픈 웨이트 모델과 API 비용
장
자료 (날짜)
링크
모델 격차
Epoch AI, 평균 3개월 (2025-10-30)
epoch.ai/data-insights/open-weights-vs-closed-weights-models
모델 격차
Epoch AI, 평균 4개월 (2026-05-29)
epoch.ai/data-insights/open-closed-eci-gap
모델 격차
Epoch AI, 사이버 6–7개월 (2026-10-16)
epoch.ai/data-insights/open-closed-cyber-eci-gap
작은 모델
Qwen3.5-9B 모델 카드 (2026-03)
huggingface.co/Qwen/Qwen3.5-9B
API 비용
Ramp, 기업 월 토큰 지출 (2026-06-08)
ramp.com/blog/ai-token-cost-for-businesses
API 비용
TechCrunch, Uber 월 $1,500 상한 (2026-06-02)
techcrunch.com/2026/06/02/uber-caps-employee-ai-spending-after-blowing-through-budget-in-four-months
API 비용
TechCrunch, 토큰 청구서 (2026-06-05)
techcrunch.com/2026/06/05/the-token-bill-comes-due-inside-the-industry-scramble-to-manage-ais-runaway-costs
API 가격
OpenAI API 가격표 (2026-10-28 조회)
developers.openai.com/api/docs/pricing
가격 하락 (뺀 장)
a16z “LLMflation” (2024-11) · Epoch AI 연 9–900배 (2025-03-12)
a16z.com/llmflation-llm-inference-cost · epoch.ai/data-insights/llm-inference-price-trends
[ 부록 A15 ]
웹 출처 (2) 큰 조직의 움직임
장
자료 (날짜)
링크
삼성
Bloomberg, 외부 AI 사용 제한 (2023-05-02)
www.bloomberg.com/news/articles/2023-05-02/samsung-bans-chatgpt-and-other-generative-ai-use-by-staff-after-leak
삼성
코리아헤럴드, 사례 3건 (2023-05, Asia News Network 전재)
asianews.network/samsung-bans-ai-chatbots-after-leak
삼성
삼성전자 뉴스룸, 가우스 공개 (2023-11-08)
news.samsung.com/global/samsung-ai-forum-2023-day-2-discussing-technological-trends-and-the-future-of-generative-ai
삼성
헤럴드경제, 외부 AI 도입·투트랙 (2026-05-25)
www.heraldk.com/article/2026052520140966904
조사
F5 2026 State of Application Strategy Report
www.f5.com/state-of-application-strategy-report
조사
Broadcom Private Cloud Outlook 2026 (2026-06)
investors.broadcom.com/news-releases/news-release-details/broadcoms-private-cloud-outlook-2026-reveals-ai-tipping-point
[ 부록 A16 ]
웹 출처 (3) 국내 공공·금융·중소기업
장
자료 (날짜)
링크
공공
파이낸스스코프, 이스트소프트 JDC 수주 (2026-10-21)
www.finance-scope.com/article/view/scp202610210007
금융
금융위원회 보도자료, 망분리 개선 로드맵 (2024-08-13)
www.fsc.go.kr/po010101/82885
중소기업
아이뉴스24, 대한상의 SGI 보고서 (2026-06-10)
www.inews24.com/view/1975233
중소기업
머니투데이방송, 중기부 중소제조 피지컬 AI 확산 전략 (2026-10-29)
news.mtn.co.kr/article/2026102910330530867
중소기업
뉴시스, 중기중앙회 502개사 조사 (2025-10-19)
www.newsis.com/view/NISX20251017_0003367189
명령어 1/10: 시작·진단
setup첫 설정 마법사scan메모리·저장소·실행 앱 요약doctor설치·연결 진단log실행 기록 조회cleanup남은 임시 파일 정리bug-report개인정보 제거 오류 보고서updateomm 최신 버전 설치명령어 2/10: 모델 찾기·선택
search모델 통합 검색info모델 상세 정보·비교fit실행 가능 여부 판정recommendPC 맞춤 모델 추천tune실행 옵션 추천benchmark품질·속도 측정evaluate코딩 능력 평가명령어 3/10: 모델 설치·관리
install허브 설치 + 앱 연결uninstall모델·링크 일괄 삭제list설치 모델·연결 상태upgrade더 나은 모델 확인pin · unpin이전 버전 보관 지정rollback보관 버전 복원export배포·백업용 내보내기명령어 4/10: 앱 연결·실행
import기존 모델 허브 통합link7개 앱 일괄 연결unlink앱 연결 해제verify실행·응답 검증run모델과 대화 시작web브라우저 관리 화면명령어 5/10: 실행 앱·기여·비교
engine install실행 앱 설치engine update실행 앱 업데이트engine uninstall실행 앱 삭제engine status · doctor실행 앱 상태 진단engine security외부 접속 허용 점검contribute자동 측정·데이터 기여arena두 모델 블라인드 비교명령어 6/10: 클러스터 구성
cluster init헤드 지정·게이트웨이 구성cluster join클러스터 합류cluster leave설정 원상 복구 후 탈퇴cluster status노드·메모리·보안 상태cluster restart누락 노드 재시작cluster handover헤드 이전cluster token직원 토큰 발급·폐기명령어 7/10: 클러스터 모델
cluster search · info클러스터용 모델 검색cluster recommend클러스터 맞춤 추천cluster install전체 노드 다운로드cluster load · unload메모리 적재·해제cluster list모델·적재 상태cluster run클러스터 모델 대화cluster benchmark클러스터 속도 측정명령어 8/10: 사내 문서 검색
rag collection문서 묶음 생성·삭제rag add · remove문서 등록·제거rag search의미·단어 통합 검색rag status색인·검색 준비 상태rag reindex색인 재생성rag embedding-model임베딩 모델 변경rag mcp코딩 도구용 검색 서버명령어 9/10: 문서 공유·도구 연결
rag share · unshare묶음별 열람 권한rag team직원 팀 관리rag remote헤드 문서 원격 사용rag connect코딩 도구 검색 연결setting agent코딩 도구 AI 연결setting agent cloud원래 설정 복원명령어 10/10: 설정
setting upload전송 데이터 선택setting telemetry측정 결과 전송처setting catalog-*추천 카탈로그 서명·복원setting auto-import신규 모델 자동 통합setting memory-guard메모리 보호 정책setting web-autostart웹 화면 자동 시작setting version업데이트 채널 전환omm 명령어 상세 1/14시작·진단 (1/2)
명령설명주요 옵션omm setup첫 설정 마법사 재실행. 하드웨어 검사와 실행 앱 설치 체크리스트를 순서대로 안내—omm scan전체 메모리, 지금 모델에 쓸 수 있는 메모리, 모델 저장 공간, 설치된 실행 앱을 한 화면에 요약—omm doctoromm 설치 상태와 Ollama 연결을 점검하고 안전한 다음 조치 안내. 경고는 정상 종료, 확실한 실패만 오류 코드 1—omm log모든 omm 명령의 실행 요약이 쌓이는 로컬 기록(~/.omm/logs) 조회. 외부 전송 없음--lines, --grep, --rebuildomm 명령어 상세 2/14시작·진단 (2/2)
명령설명주요 옵션omm cleanup중단된 설치가 남긴 임시 .gguf 파일과, 원본이 지워져 끊긴 실행 앱 링크 정리—omm bug-report개인정보를 제거한 오류 보고 묶음을 미리 보고 로컬에 저장. 업로드 기능 없음--include, --saveomm update최신 소스로 omm 재설치와 데이터 갱신. setting version에서 고른 채널(stable/beta) 기준—omm help [명령]명령별 도움말. --help와 동일--all, --flagsomm 명령어 상세 3/14모델 찾기·선택 (1/2)
명령설명주요 옵션omm search <검색어>추천 카탈로그, 캐시된 후보, Hugging Face·ModelScope를 이름 하나로 통합 검색--skip-unfit, --limit, --provideromm info <모델...>모델 1개의 상세 정보, 또는 여러 모델의 나란히 비교. 설치·미설치 모델 혼합 가능—omm fit <모델>설치 전후와 관계없이 지금 이 PC 메모리에 들어가는지 막대로 판정. 다른 앱 사용량, 운영체제 여유분, 설치 상한 표시—omm recommend실제 설치·측정 데이터로 학습한 LocalFit 모델로 이 PC에 맞는 모델 순위 제시. 학습 모델이 없으면 정적 규칙 사용--profile, --refresh-metadataomm 명령어 상세 4/14모델 찾기·선택 (2/2)
명령설명주요 옵션omm tune <모델>모델별 컨텍스트 길이, GPU 오프로드, 스레드 수, 배치 크기 추천--apply, --save, --engineomm benchmark <모델...>재현 가능한 짧은 품질 문항과 생성 속도 측정. Ollama 측정값은 이 PC의 추천 속도 보정에 반영(외부 전송 없음)--pack, --speed-runsomm evaluate <모델>격리된 Python 코딩 과제로 설치 모델의 코딩 능력 평가. 생성 코드는 Docker·Podman 안에서만 실행--pack, --outputomm arena <모델...>설치한 두 모델의 답을 이름 없이 비교하고 투표. 투표 업로드는 세션 끝에 동의한 경우만--keep, --leaderboardomm 명령어 상세 5/14모델 설치·관리
명령설명주요 옵션omm install <모델>모델을 중앙 허브에 한 번 받고, 설치된 실행 앱 전부에 자동 연결--quant, --force, --load-check, --skip-unfitomm uninstall <파일|all>모델 삭제와 함께 모든 링크·manifest 정리. all 지정 시 omm으로 설치한 모델 전체--dry-runomm listomm으로 설치한 모델 목록과 앱별 연결 상태--engineomm upgrade [모델]설치 모델보다 나은 후속 모델이나, 같은 저장소의 더 좋은 양자화 버전 중 이 PC에 들어가는 것 제안 후 선택 설치--dry-runomm pin <모델>다음 install --force 전에 현재 버전을 보관하도록 지정. 실제 보관은 재설치 직전에 수행—omm unpin <모델>pin 해제. 이미 보관된 버전은 삭제—omm rollback <모델>보관된 이전 버전으로 복원. 다시 실행하면 최신 버전으로 되돌림—omm export <파일> <경로>배포·백업용 내보내기. 가능하면 하드링크, 아니면 실제 복사. 심볼릭 링크 미사용--forceomm 명령어 상세 6/14앱 연결·실행
명령설명주요 옵션omm import [경로]다른 실행 앱이 받아 둔 .gguf 파일을 찾아 허브로 통합. 같은 파일은 해시로 묶고 나머지는 링크로 교체—omm link [모델...]7개 실행 앱(Ollama, LM Studio, Jan, AnythingLLM, Msty, text-generation-webui, KoboldCpp) 연결 재검증과 복구--engine, --to <폴더>, --forceomm unlink <파일...>특정 실행 앱에서만 모델 연결 해제. 허브 파일과 다른 앱 연결은 유지--engineomm verify <모델>실제 실행 앱에 모델을 올려 짧은 질문을 보내고 답이 나오는지 확인. 필요하면 실행 앱을 켰다가 다시 끔--engine, --keep-loadedomm run <모델>설치 모델과 대화 시작. Ollama는 터미널에서, 화면형 앱은 해당 앱을 열어 실행--engineomm web모델 관리용 로컬 브라우저 화면 실행. 이 컴퓨터 안에서만 접속 가능--port, --openomm contribute이 PC에 맞는 모델을 차례로 받아 측정하고 동의한 결과를 업로드. 임시로 받은 모델만 삭제--max-minutes, --max-download-gb, --max-modelsomm 명령어 상세 7/14실행 앱 관리
명령설명주요 옵션omm engine install [앱]Ollama, LM Studio 등 실행 앱 설치. 인자 없이 실행하면 체크리스트 선택—omm engine update <앱>실행 앱을 설치한 패키지 관리자로 업데이트--dry-runomm engine uninstall <앱>실행 앱 패키지만 삭제. omm 모델 허브는 유지--dry-runomm engine status [앱]설치 여부, 패키지 버전, 로컬 API 상태를 구분해 표시--apiomm engine doctor [앱]읽기 전용 진단과 빠진 구성 요소 안내—omm engine security [앱]실행 앱 서버가 다른 기기의 접속을 허용하는지 점검--fix-local-onlyomm 명령어 상세 8/14클러스터 구성 (헤드·멤버)
명령설명주요 옵션omm cluster init이 Mac을 헤드로 지정. exo, 방화벽, 직원용 HTTPS 게이트웨이 구성—omm cluster join <이름>헤드가 만든 클러스터에 이 Mac 합류. 네트워크, 절전, exo 서비스 자동 설정—omm cluster leave이 Mac의 클러스터 방화벽, 서비스, 설정을 원래대로 되돌리고 탈퇴—omm cluster status노드, 메모리, RDMA, 방화벽, 게이트웨이, 문서 검색 상태와 문제 목록—omm cluster restart켜져 있지만 클러스터에서 빠진 Mac의 exo 재시작—omm cluster handover <Mac>헤드 역할을 다른 Mac으로 이전. 문서 저장소와 게이트웨이를 새 헤드로 이동—omm cluster token add <이름>직원 1명용 접속 토큰 발급. 토큰은 한 번만 표시—omm cluster token list직원 토큰 목록(이름, 발급 시각)—omm cluster token revoke <이름>직원 토큰 폐기. 게이트웨이가 즉시 거부—omm 명령어 상세 9/14클러스터 모델
명령설명주요 옵션omm cluster search <검색어>exo가 실행할 수 있는 MLX 모델을 Hugging Face에서 검색—omm cluster recommend클러스터 전체 여유 메모리에 들어가는 가장 큰 exo 모델 추천—omm cluster info <모델>모델 정보, 보유한 Mac, 지금 가능한 배치 방법—omm cluster install <모델>모든 Mac에 모델 다운로드(메모리 적재는 안 함). 헤드 전용—omm cluster uninstall <모델>모든 Mac에서 모델 파일 삭제. 적재돼 있으면 먼저 해제. 헤드 전용—omm cluster load <모델>모델을 클러스터 메모리에 적재해 직원이 쓸 수 있게 함. 헤드 전용--sharding, --macs, --onomm cluster unload <모델>적재된 모델의 메모리 해제. 파일은 유지. 헤드 전용—omm cluster list클러스터의 모델 목록과 적재 여부—omm cluster run <모델>클러스터 모델과 터미널 대화. 설치돼 있으면 먼저 적재—omm cluster benchmark <모델>클러스터에서 첫 토큰 시간과 초당 토큰 수 측정. 외부 전송 없음—omm 명령어 상세 10/14사내 문서 검색 (RAG)
명령설명주요 옵션omm rag collection create <이름>빈 문서 묶음 생성. rag remote 설정 시 헤드에 생성—omm rag collection list검색 가능한 묶음 목록, 문서 수, 소유자, 공유 대상—omm rag collection delete <이름>묶음과 저장된 텍스트·색인 삭제. 원본 파일은 유지—omm rag add <묶음> <파일...>PDF, TXT, Markdown, HTML, HWPX 문서를 묶음에 추가--replaceomm rag remove <묶음> <이름>문서 1개의 텍스트와 색인 삭제. 원본 파일은 유지—omm rag search <질문>의미 검색과 단어 검색을 합친 하이브리드 검색으로 근거 문단 찾기. 의미 검색 불가 시 단어 검색과 사유 표시--collection, --limitomm rag status묶음, 임베딩 모델, 의미 검색 준비 여부, 재색인이 필요한 문서—omm rag reindex현재 임베딩 모델로 의미 검색용 벡터 재생성--collection, --allomm rag embedding-model set <모델>의미 검색용 로컬 Ollama 임베딩 모델 변경. 변경 후 reindex 필요--base-urlomm rag mcp코딩 도구가 실행하는 로컬 문서 검색 MCP 서버(stdin/stdout)—omm 명령어 상세 11/14문서 공유·원격
명령설명주요 옵션omm rag share <묶음> <직원>직원 또는 팀에게 묶음 검색 권한 부여(소유자·헤드 관리자)--teamomm rag unshare <묶음> <직원>직원 또는 팀의 묶음 검색 권한 회수--teamomm rag team create <팀>빈 팀 생성(헤드)—omm rag team add <팀> <직원>팀에 직원(토큰 이름) 추가—omm rag team remove <팀> <직원>팀에서 직원 제외—omm rag team list팀과 구성원 목록—omm rag team delete <팀>팀과 그 팀에 준 공유 권한 전체 삭제—omm rag remote set <주소>인증서와 직원 토큰 확인 후 이 PC의 rag를 헤드의 공유 문서로 연결--tokenomm rag remote clear헤드 연결 해제. 이 PC의 문서로 복귀—omm 명령어 상세 12/14코딩 도구 연결
명령설명주요 옵션omm rag connect <도구>코딩 도구(Claude Code, Codex, pi, Cursor)에 omm 문서 검색을 MCP 서버로 등록. 기존 설정 백업--remoteomm rag disconnect <도구>코딩 도구에서 omm MCP 항목만 제거. 다른 설정은 유지—omm setting agent local <도구>설정 백업 후 코딩 도구를 이 PC의 Ollama 모델에 연결--model, --base-urlomm setting agent cluster <도구>설정 백업 후 코딩 도구를 사내 클러스터 게이트웨이에 연결--modelomm setting agent cloud <도구>원래 연결로 복원. 그 사이 바꾼 다른 설정은 유지—omm setting agent status <도구>저장된 연결 상태 확인. 모델 적재나 인증 정보 노출 없음—omm 명령어 상세 13/14설정 (1/2)
명령설명주요 옵션omm setting upload익명 전송 항목 선택(측정 결과, 사용 통계, 오류 보고). 기본값은 꺼짐 또는 매번 확인—omm setting upload benchmark · crash · usage · votes항목별 전송 정책 변경. usage는 다음 전송 내용 미리 보기, votes는 대기 중인 투표 수 표시--enable, --disable, --askomm setting telemetry측정 결과 전송 주소 설정--endpointomm setting catalog-trust앞으로 받는 추천 카탈로그에 서명 검증 의무화--public-keyomm setting catalog-status추천 카탈로그 신뢰·복원 상태—omm setting catalog-rollback직전의 다른 추천 카탈로그로 복원—omm 명령어 상세 14/14설정 (2/2)
명령설명주요 옵션omm setting auto-import enable · disable · status실행 앱이 새로 받은 모델을 백그라운드에서 자동으로 허브에 통합—omm setting memory-guard실행 중 메모리 부족 시 보호 정책(동의 기반) 확인·변경--policyomm setting runtime-profile <모델>저장된 실행 옵션 확인, 또는 마지막 저장 취소--restoreomm setting web-autostart enable · disable · status로그인 시 웹 관리 화면 자동 시작(기본 꺼짐)—omm setting versionomm 업데이트 채널(stable·beta) 확인·전환. 전환 즉시 적용--stable, --betaomm setting theme터미널 출력 색 테마 확인·변경--set